
多智能体 (Multi-agent)
多智能体系统(Multi-agent systems)协调专业化的组件来应对复杂的工作流。然而,并非所有复杂任务都需要这种方法——一个配备了合适(有时是动态的)工具和提示词的单一智能体,往往也能取得类似的效果。
TIP
如需内置的多智能体支持,请使用 Deep Agents:这是一个构建在 LangChain 之上的更高级别运行框架(harness),自带子智能体、技能、规划、虚拟文件系统以及上下文管理功能。
为什么需要多智能体?
当开发者说他们需要“多智能体”时,通常是在寻求以下一种或多种能力:
- 上下文管理 (Context management):提供专业化知识,同时避免超出模型的上下文窗口负荷。如果上下文无限且延迟为零,你可以把所有知识直接倾倒进单个提示词中——但事实并非如此,因此你需要通过特定模式有选择地呈现相关信息。
- 分布式开发 (Distributed development):允许不同团队独立开发和维护各项能力,并通过清晰的边界将它们组合成一个更大的系统。
- 并行化 (Parallelization):为各个子任务派生专业的工作单元并并发执行,从而更快获取结果。
多智能体模式在以下场景中尤为宝贵:当单一智能体拥有过多工具而在选择使用哪一个时决策变差;当任务需要包含大量上下文的专业知识(超长提示词和领域专属工具);或者当你需要执行时序约束、仅在满足某些条件后才解锁相应能力时。
TIP
多智能体设计的核心在于上下文工程——即决定每个智能体可以看到哪些信息。系统的质量取决于确保每个智能体都能获取契合其任务的正确数据。
模式
以下是构建多智能体系统的主要模式,每种模式分别适用于不同的用例:
| 模式 | 工作原理 |
|---|---|
| 子智能体 (Subagents) | 主智能体将子智能体作为工具进行协调。所有路由均经过主智能体,由其决定何时以及如何调用各个子智能体。 |
| 移交 (Handoffs) | 行为基于状态动态变化。工具调用会更新状态变量,进而触发路由或配置变更,从而切换智能体或调整当前智能体的工具与提示词。 |
| 技能 (Skills) | 按需加载专业化的提示词与知识。单一智能体始终保持控制权,同时根据需要从技能中加载上下文。 |
| 路由器 (Router) | 通过路由步骤对输入进行分类,并将其引导至一个或多个专业智能体。各结果最终合成为综合响应。 |
| 自定义工作流 (Custom workflow) | 利用 LangGraph 构建定制化执行流,混合确定性逻辑与智能体自主行为。可将其他模式作为节点嵌入到工作流中。 |
选择模式
使用下表根据你的需求匹配合适的模式:
| 模式 | 分布式开发 | 并行化 | 多跳 (Multi-hop) | 直接用户交互 |
|---|---|---|---|---|
| 子智能体 (Subagents) | ⭐⭐⭐⭐⭐ | ⭐⭐⭐⭐⭐ | ⭐⭐⭐⭐⭐ | ⭐ |
| 移交 (Handoffs) | - | - | ⭐⭐⭐⭐⭐ | ⭐⭐⭐⭐⭐ |
| 技能 (Skills) | ⭐⭐⭐⭐⭐ | ⭐⭐⭐ | ⭐⭐⭐⭐⭐ | ⭐⭐⭐⭐⭐ |
| 路由器 (Router) | ⭐⭐⭐ | ⭐⭐⭐⭐⭐ | - | ⭐⭐⭐ |
- 分布式开发 (Distributed development):不同团队能否独立维护各个组件?
- 并行化 (Parallelization):多个智能体能否并发执行?
- 多跳 (Multi-hop):该模式是否支持串行调用多个子智能体?
- 直接用户交互 (Direct user interaction):子智能体能否直接与用户对话?
TIP
你可以混合搭配多种模式!例如,子智能体架构可以调用那些会触发自定义工作流或路由智能体的工具。子智能体甚至可以使用技能模式来按需加载上下文。可能性是无穷无尽的!
架构图示
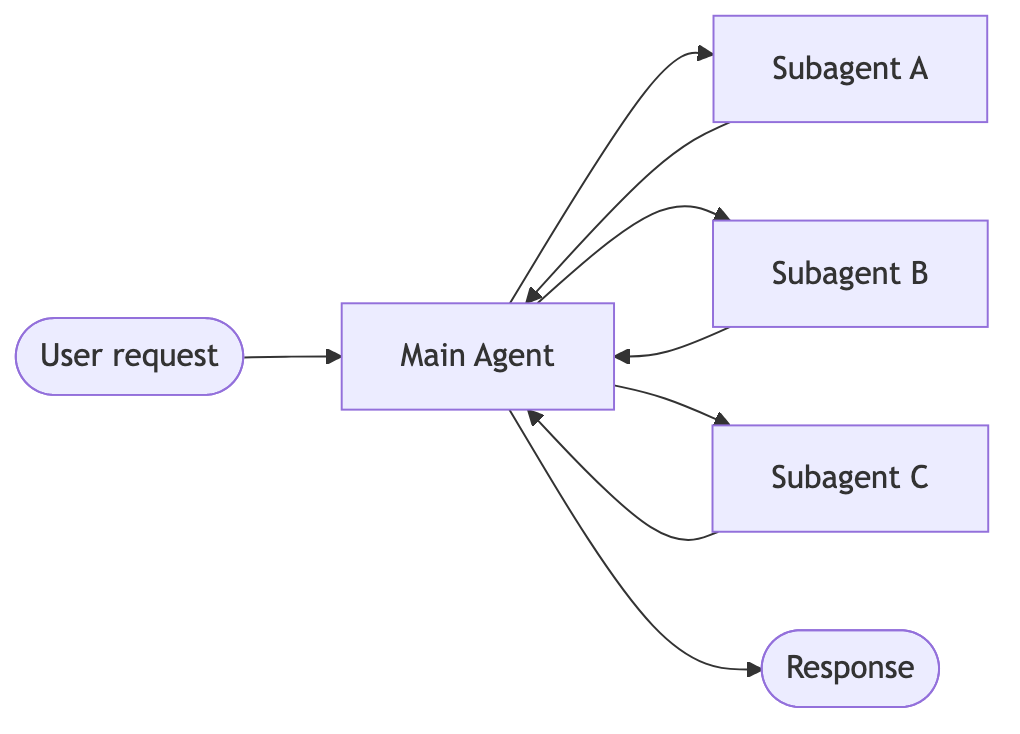
子智能体 (Subagents)
主智能体将子智能体作为工具进行协调。所有路由都经过主智能体。
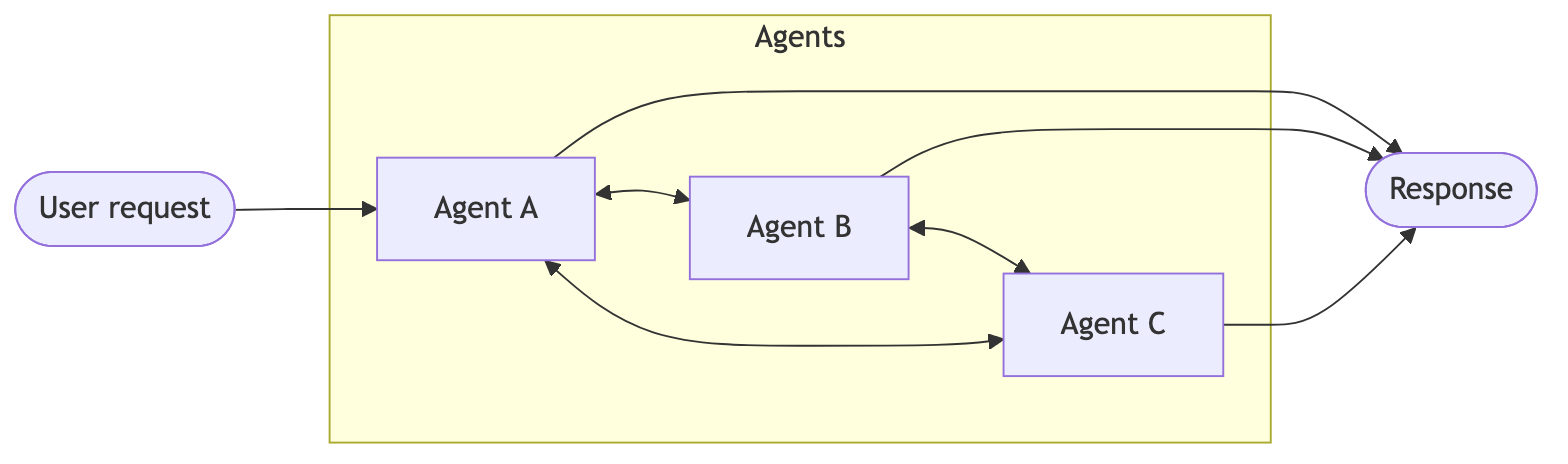
移交 (Handoffs)
智能体之间通过工具调用相互转移控制权。每个智能体都可以移交给其他智能体,或直接响应用户。
技能 (Skills)
单一智能体在保持控制权的同时,按需加载专业化的提示词与知识。

路由器 (Router)
路由步骤对输入进行分类并将其引导至专业智能体。各结果最终合成为综合响应。

性能对比
不同的模式具有不同的性能特性。理解这些权衡有助于你根据延迟和成本需求选择合适的模式。
关键指标:
- 模型调用次数 (Model calls):LLM 调用的次数。调用次数越多 = 延迟越高(尤其是串行调用时),且单次请求的 API 成本越高。
- 处理的 Token 数 (Tokens processed):所有调用所使用的上下文窗口总量。Token 越多 = 处理成本越高,且可能触碰上下文上限。
单次请求
用户:“买咖啡”
一个专业的咖啡智能体/技能可以调用 buy_coffee 工具。
| 模式 | 模型调用次数 | 最优匹配 |
|---|---|---|
| 子智能体 (Subagents) | 4 | |
| 移交 (Handoffs) | 3 | ✅ |
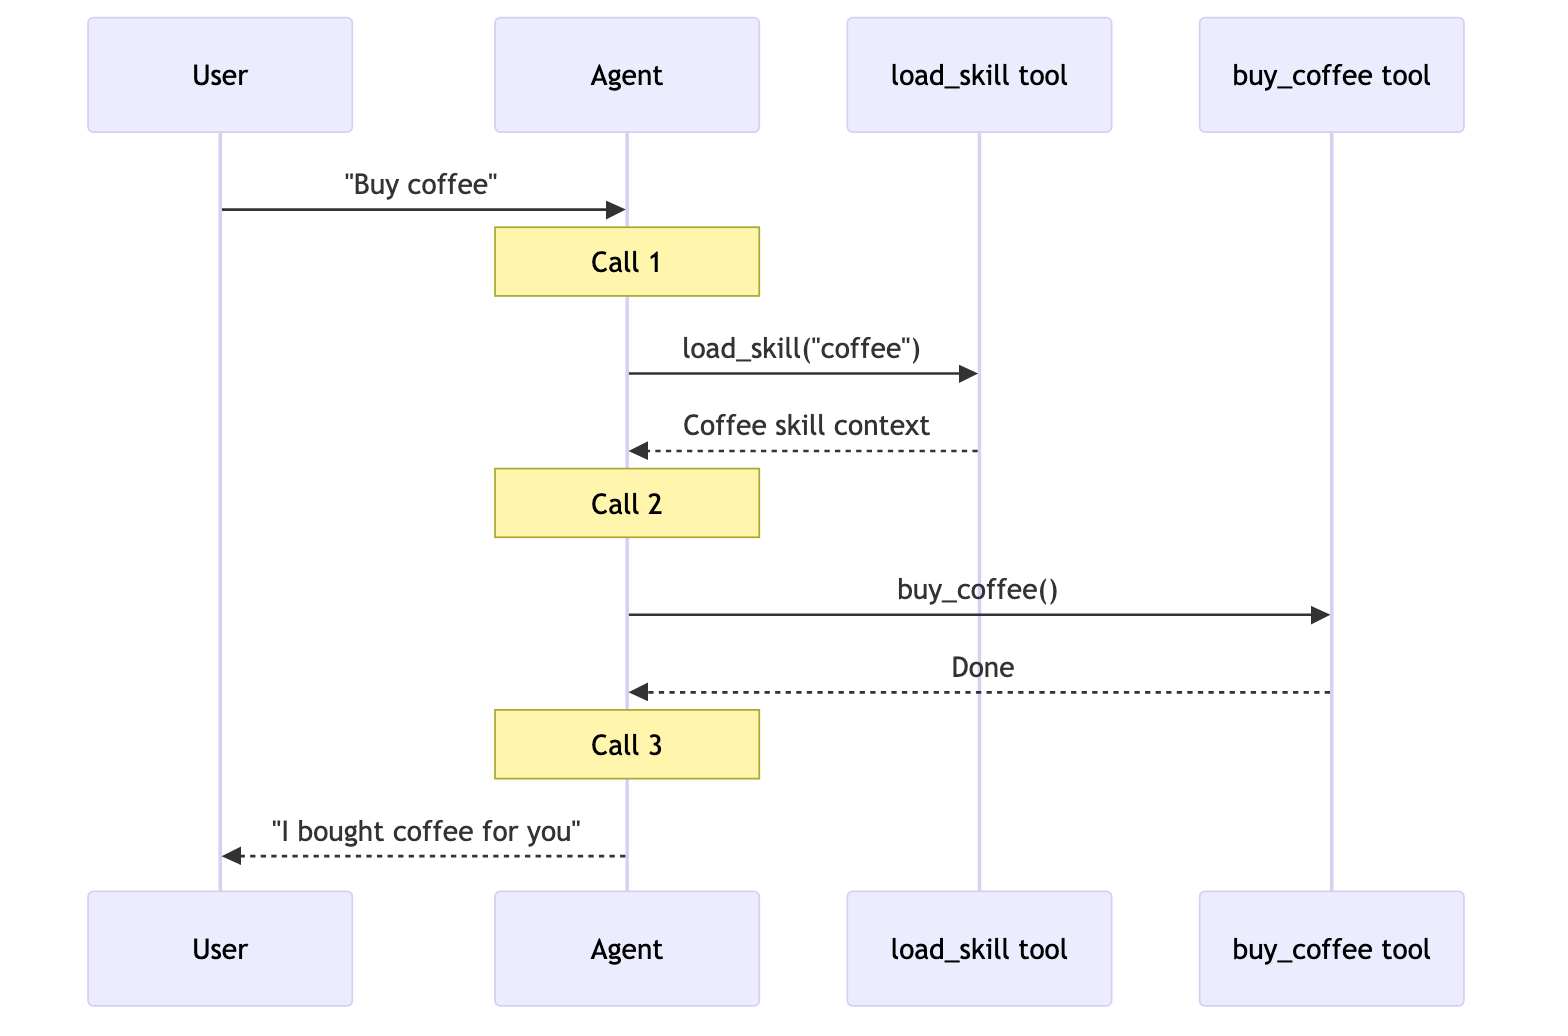
| 技能 (Skills) | 3 | ✅ |
| 路由器 (Router) | 3 | ✅ |
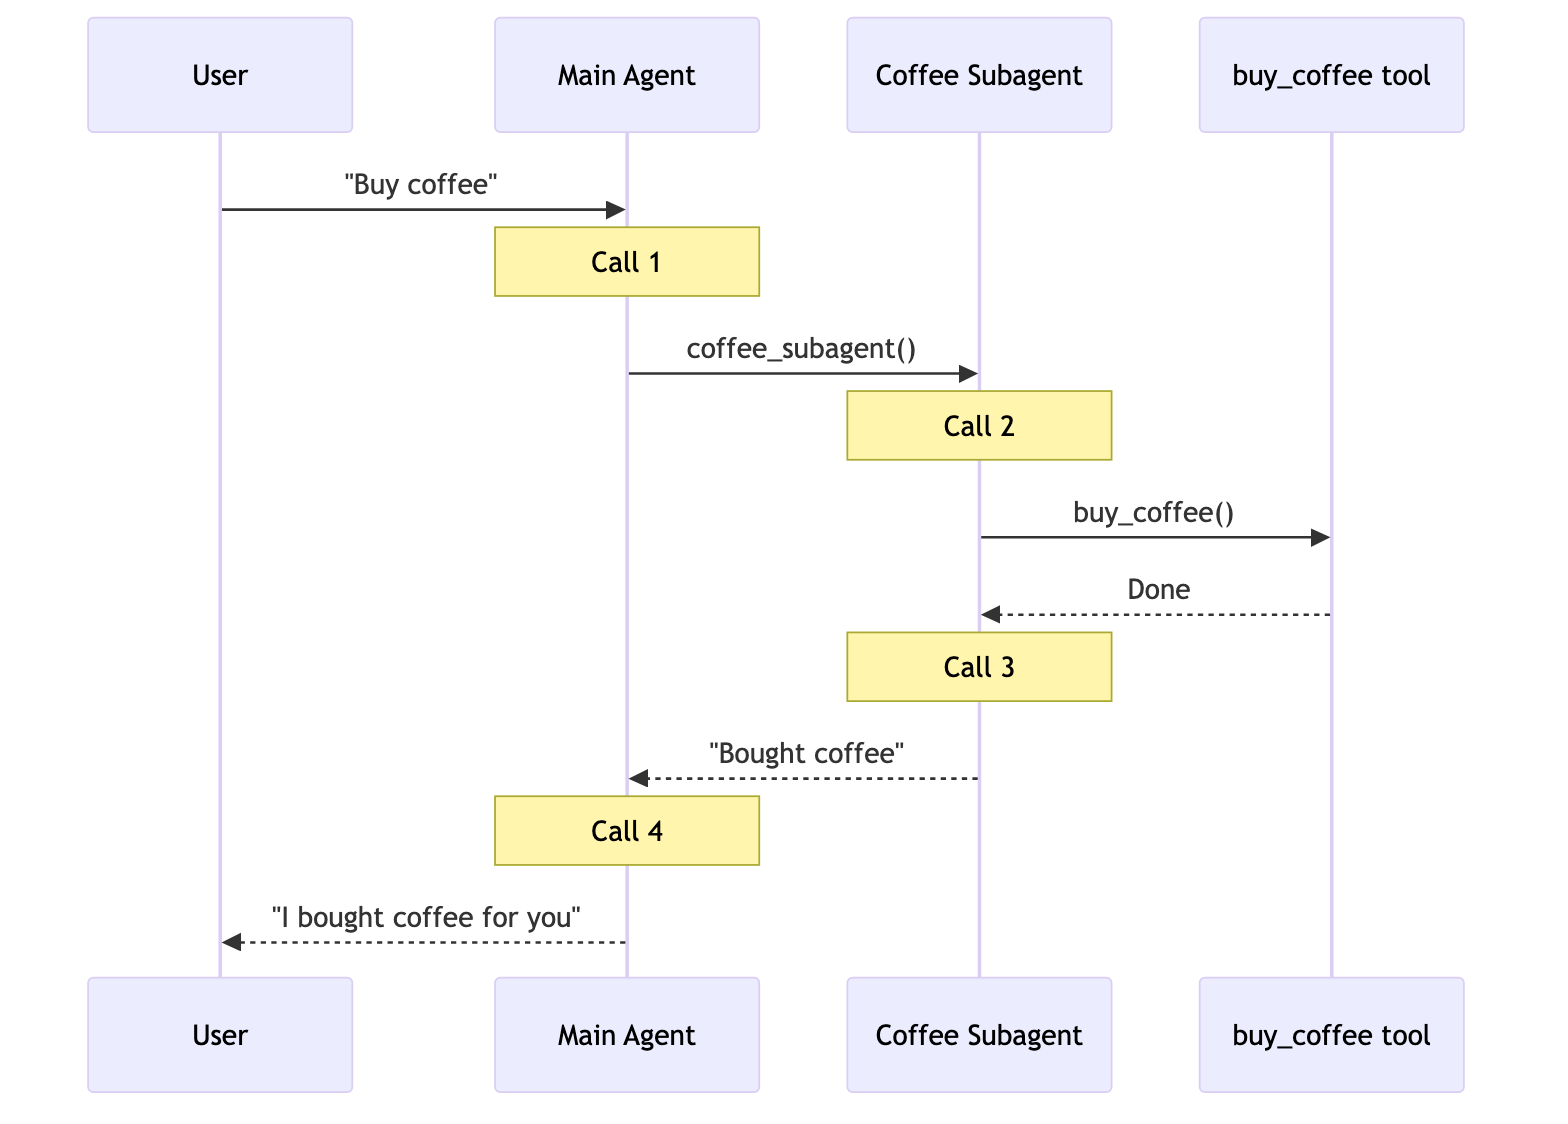
子智能体 (Subagents)
4 次模型调用:
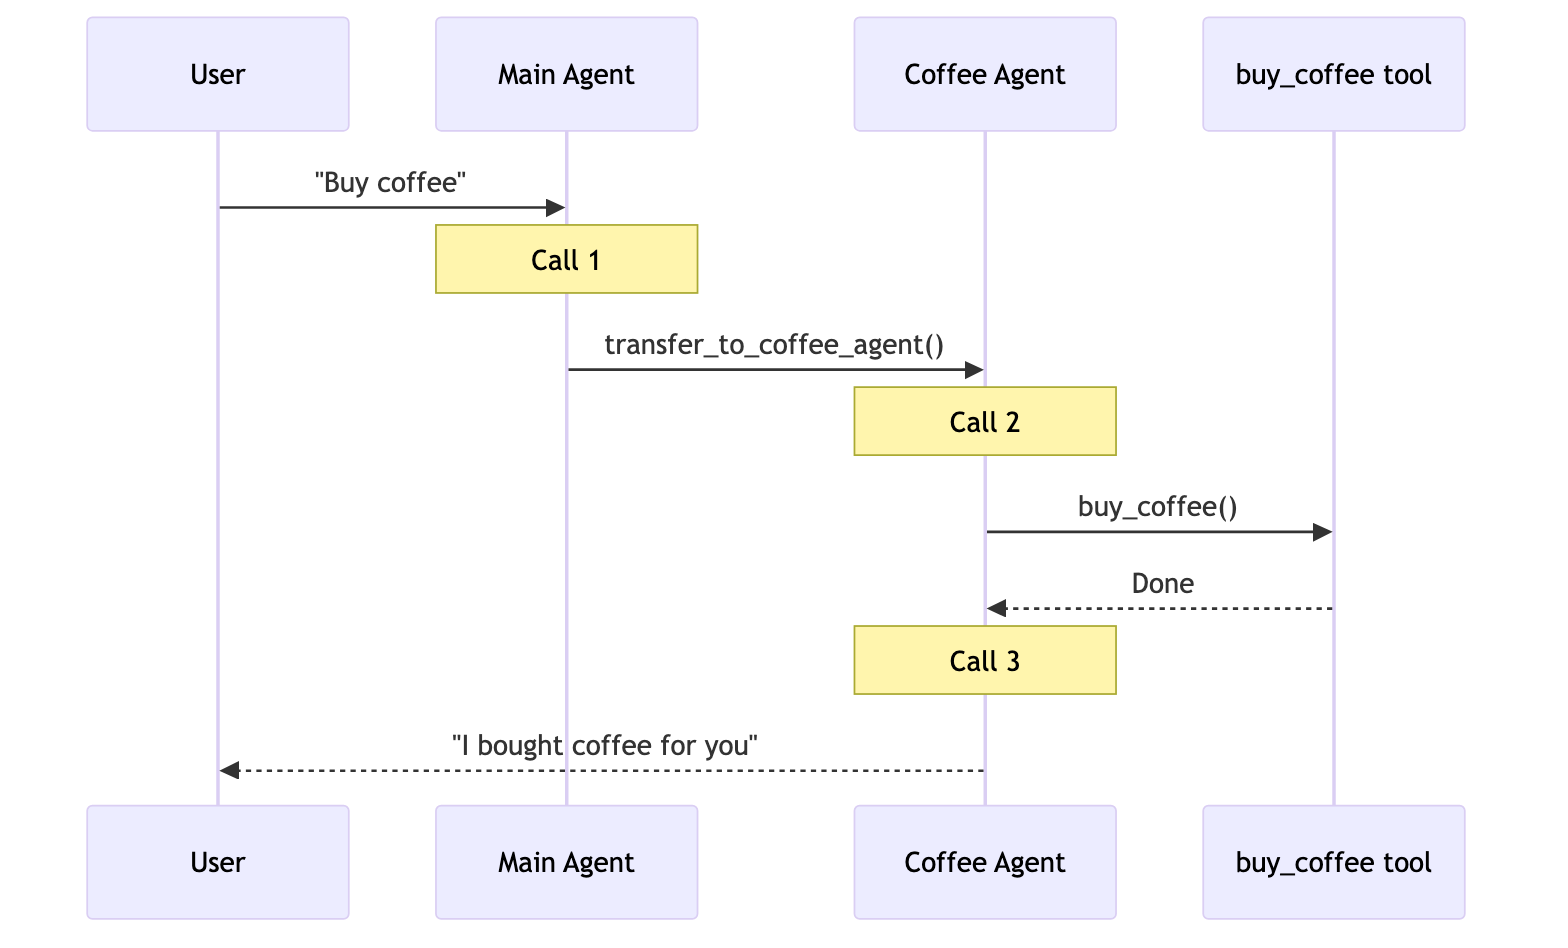
移交 (Handoffs)
3 次模型调用:
技能 (Skills)
3 次模型调用:
路由器 (Router)
3 次模型调用:
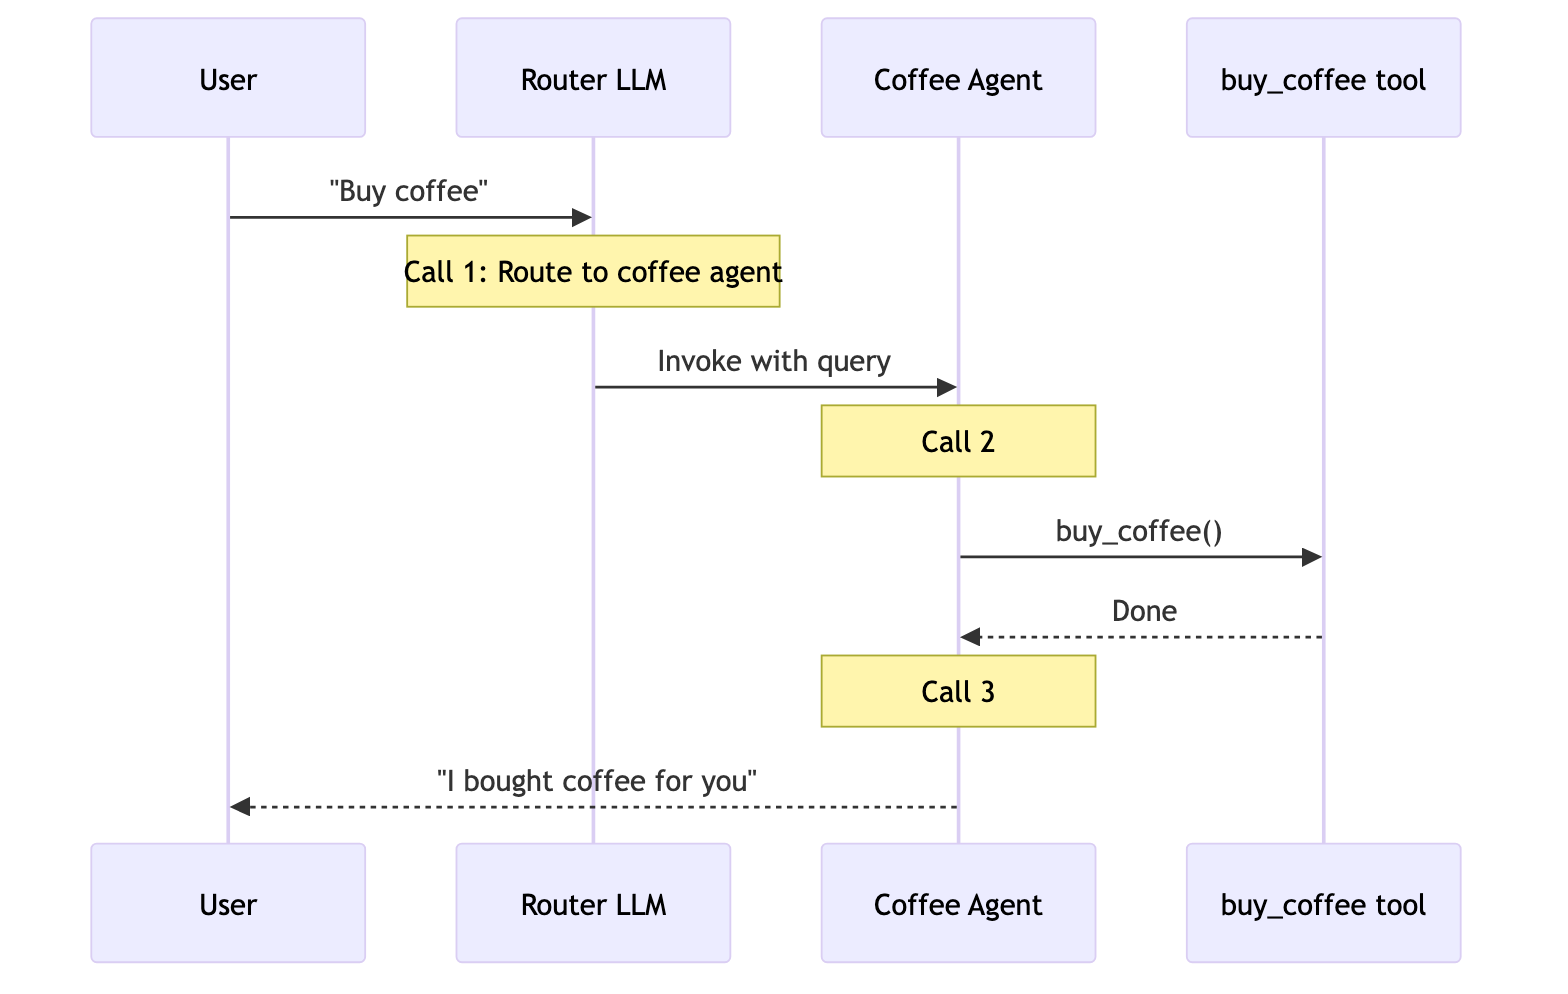
核心洞察: 移交、技能和路由器在处理单一任务时效率最高(各需 3 次调用)。子智能体增加了一次额外调用,因为结果需要流回主智能体——这一开销换取了集中式的控制能力。
重复请求
第 1 轮:“买咖啡”
第 2 轮:“再买一杯咖啡”
用户在同一个会话中重复相同的请求。
| 模式 | 第 2 轮调用次数 | 总计(两轮合计) | 最优匹配 |
|---|---|---|---|
| 子智能体 (Subagents) | 4 | 8 | |
| 移交 (Handoffs) | 2 | 5 | ✅ |
| 技能 (Skills) | 2 | 5 | ✅ |
| 路由器 (Router) | 3 | 6 |
子智能体 (Subagents)
再次调用 4 次 → 总计 8 次
- 子智能体在设计上是无状态的——每次调用都遵循相同的流程
- 主智能体维护会话上下文,但子智能体每次都从全新状态开始
- 这提供了强上下文隔离,但会重复完整的流程
移交 (Handoffs)
2 次调用 → 总计 5 次
- 咖啡智能体自第 1 轮起仍然处于激活状态(状态持久化)
- 无需再次移交——智能体直接调用
buy_coffee工具(调用 1) - 智能体响应用户(调用 2)
- 跳过移交步骤,节省 1 次调用
技能 (Skills)
2 次调用 → 总计 5 次
- 技能上下文已加载至会话历史中
- 无需重新加载——智能体直接调用
buy_coffee工具(调用 1) - 智能体响应用户(调用 2)
- 复用已加载技能,节省 1 次调用
路由器 (Router)
再次调用 3 次 → 总计 6 次
- 路由器是无状态的——每次请求都需要一次 LLM 路由调用
- 第 2 轮:路由器 LLM 调用 (1) → 牛奶智能体调用 buy_coffee (2) → 牛奶智能体响应 (3)
- 可通过将其作为工具封装在有状态的智能体中来进行优化
核心洞察: 有状态模式(移交、技能)在重复请求中可节省 40-50% 的调用次数。子智能体保持每次请求成本恒定——这种无状态设计提供了强大的上下文隔离,但代价是重复的模型调用。
多领域
用户:“对比用于 Web 开发的 Python、JavaScript 和 Rust”
每种语言的智能体/技能包含约 2000 个 Token 的文档。所有模式都可以发起并行工具调用。
| 模式 | 模型调用次数 | 总 Token 数 | 最优匹配 |
|---|---|---|---|
| 子智能体 (Subagents) | 5 | ~9K | ✅ |
| 移交 (Handoffs) | 7+ | ~14K+ | |
| 技能 (Skills) | 3 | ~15K | |
| 路由器 (Router) | 5 | ~9K | ✅ |
子智能体 (Subagents)
5 次调用,约 9K Token
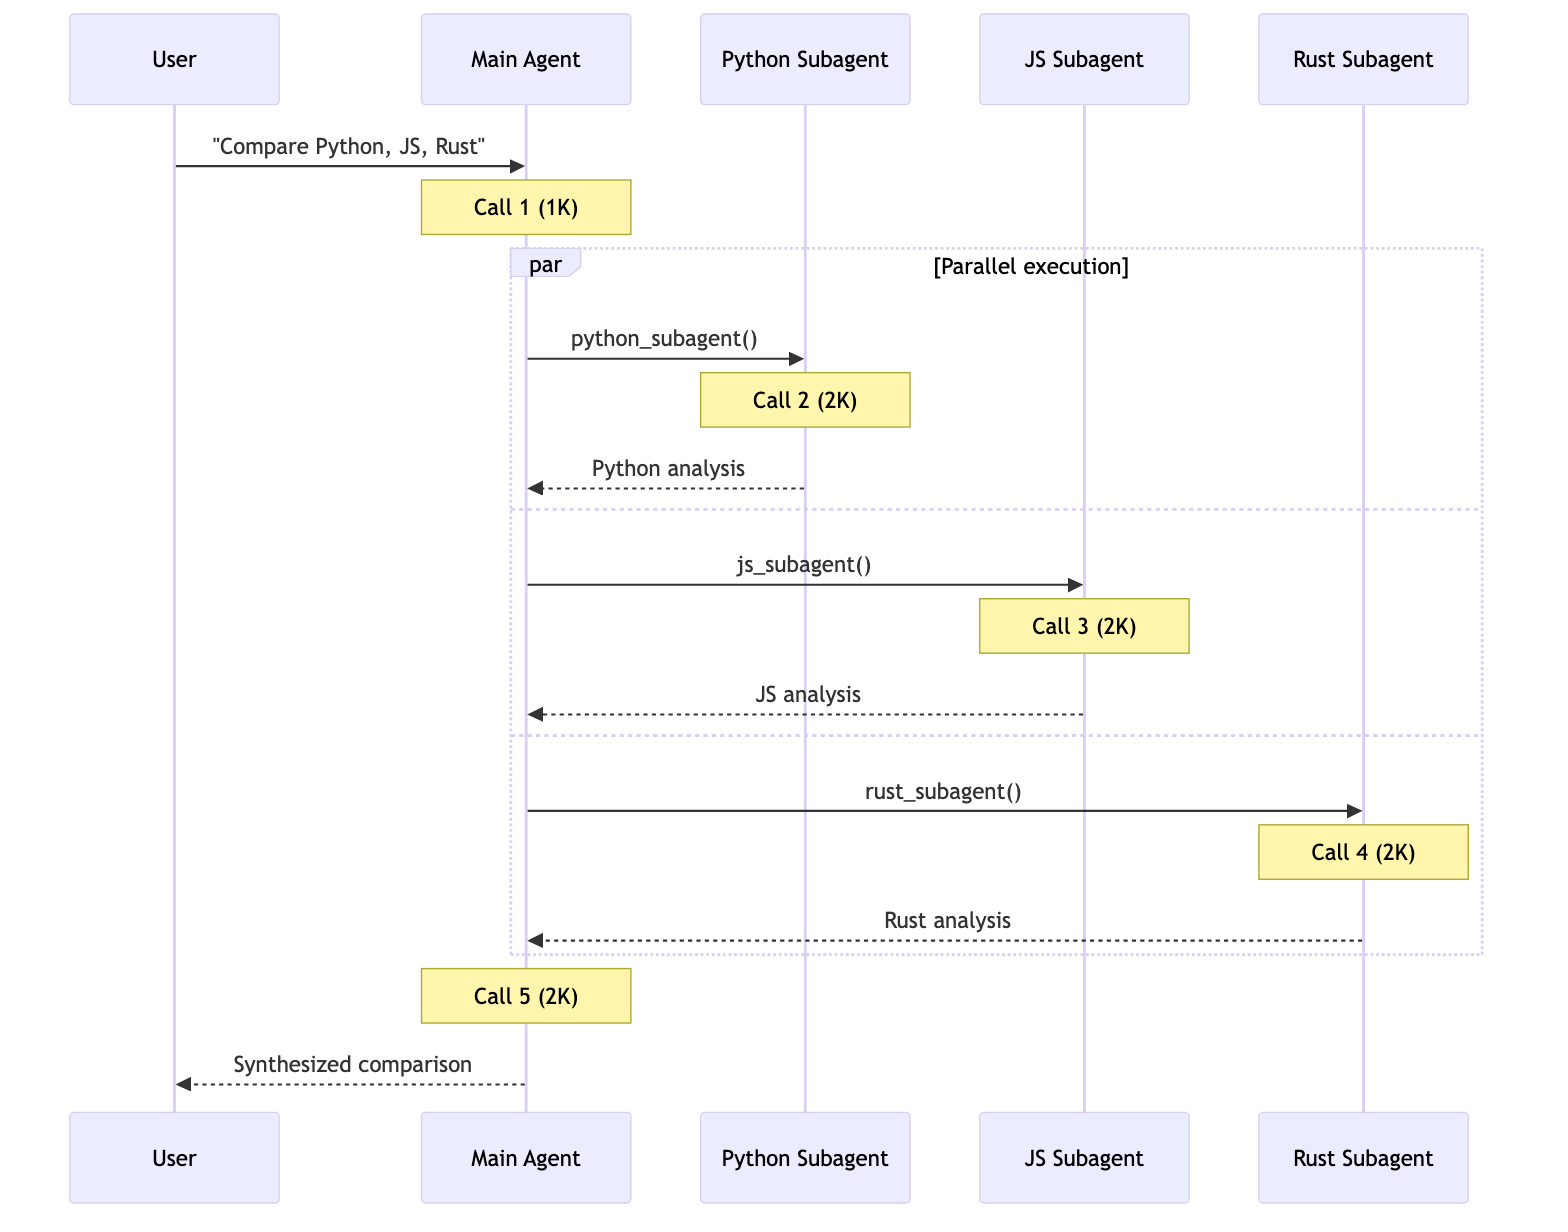
每个子智能体都在隔离环境中运行,仅包含与其相关的上下文。总计:9K Token。
移交 (Handoffs)
7+ 次调用,约 14K+ Token
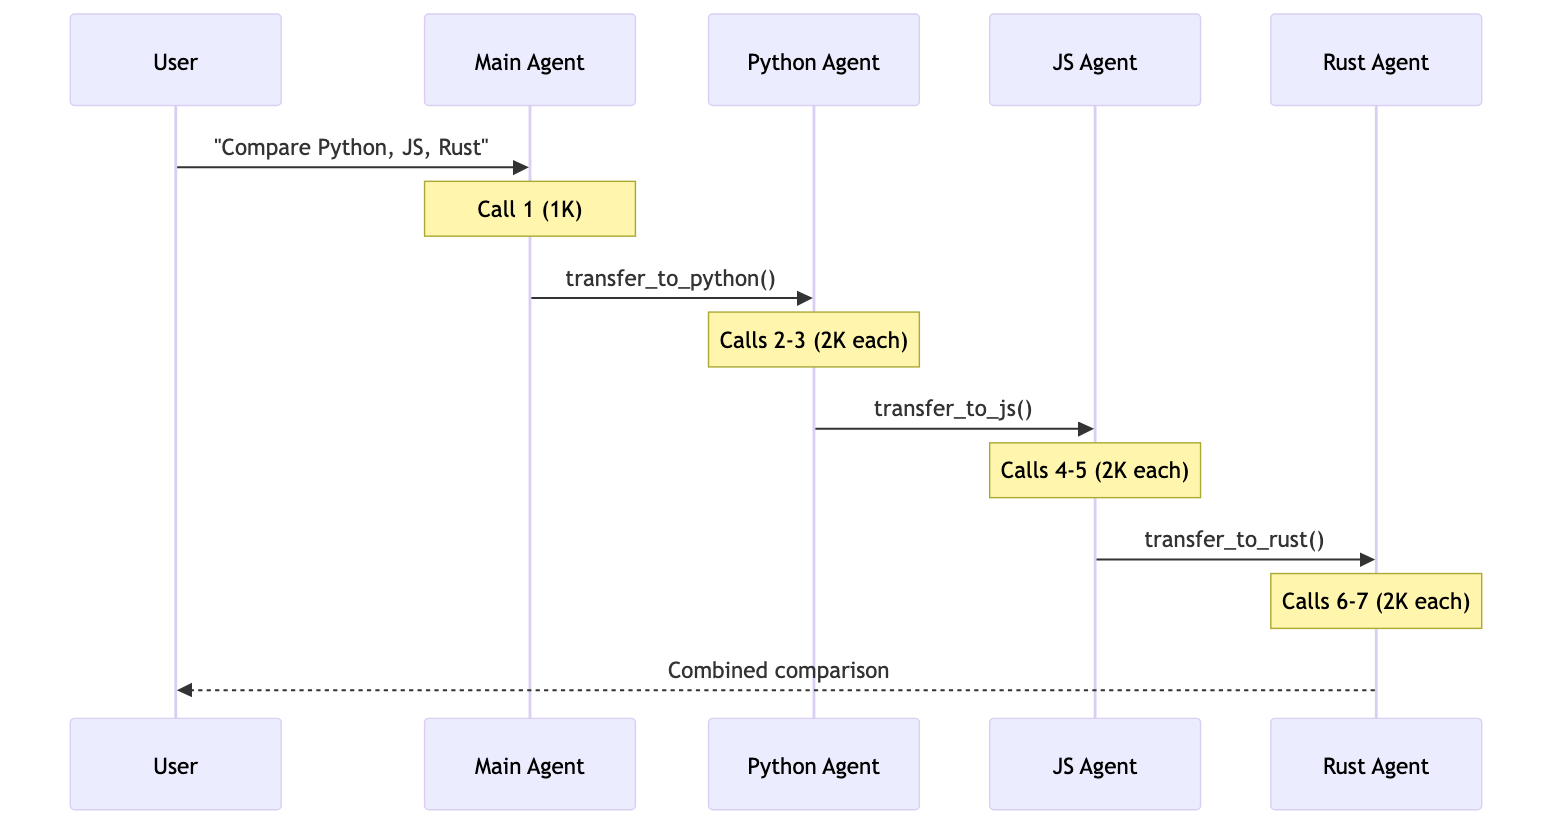
移交模式按顺序执行——无法并行调研这三种语言。不断增长的会话历史增加了开销。总计:约 14K+ Token。
技能 (Skills)
3 次调用,约 15K Token
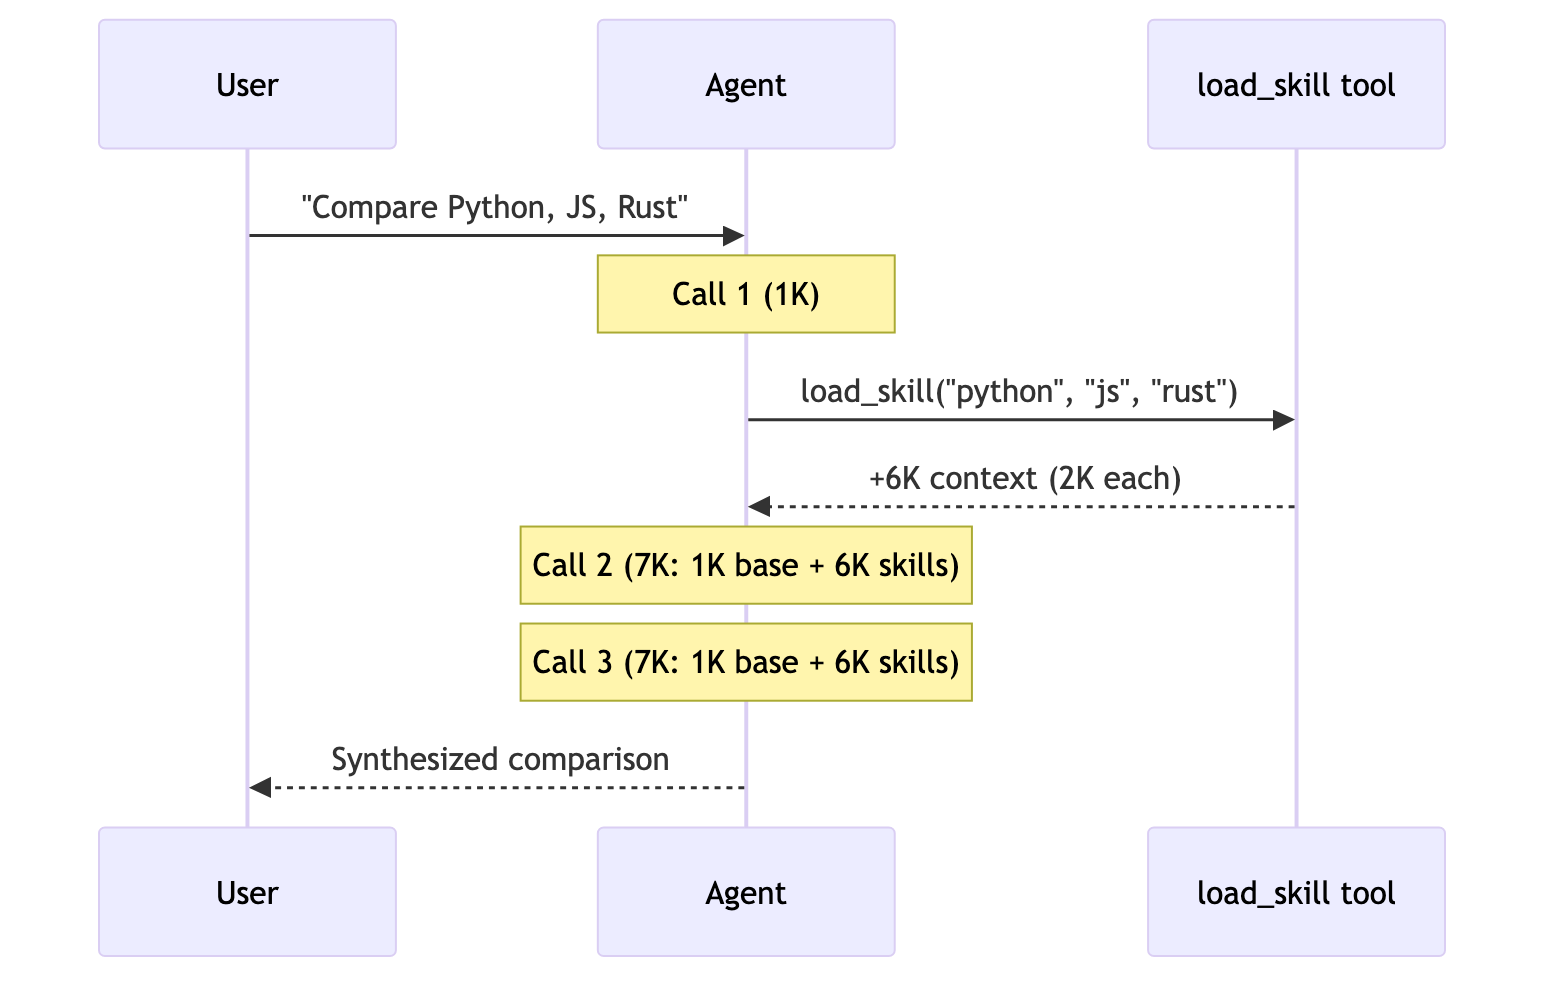
加载之后,后续的每一次调用都会处理全部 6K Token 的技能文档。由于上下文隔离,子智能体模式总体处理的 Token 减少了 67%。总计:15K Token。
路由器 (Router)
5 次调用,约 9K Token

路由器使用 LLM 进行路由,随后并行调用各个智能体。与子智能体类似,但具有显式的路由步骤。总计:9K Token。
核心洞察: 对于多领域任务,支持并行执行的模式(子智能体、路由器)效率最高。技能模式的调用次数较少,但由于上下文累积导致 Token 占用很高。移交模式在此场景下效率低下——它必须按顺序执行,无法利用并行工具调用来同时咨询多个领域。
总结
以下是各模式在这三种场景下的综合对比:
| 模式 | 单次请求 | 重复请求 | 多领域 |
|---|---|---|---|
| 子智能体 (Subagents) | 4 次调用 | 8 次调用 (4+4) | 5 次调用,9K Token |
| 移交 (Handoffs) | 3 次调用 | 5 次调用 (3+2) | 7+ 次调用,14K+ Token |
| 技能 (Skills) | 3 次调用 | 5 次调用 (3+2) | 3 次调用,15K Token |
| 路由器 (Router) | 3 次调用 | 6 次调用 (3+3) | 5 次调用,9K Token |
选择合适模式:
| 优化目标 | 子智能体 (Subagents) | 移交 (Handoffs) | 技能 (Skills) | 路由器 (Router) |
|---|---|---|---|---|
| 单次请求 | ✅ | ✅ | ✅ | |
| 重复请求 | ✅ | ✅ | ||
| 并行执行 | ✅ | ✅ | ||
| 大上下文领域 | ✅ | ✅ | ||
| 简单、专注的任务 | ✅ |