
安全护栏 (Guardrails)
为智能体实现安全检查与内容过滤防护体系
安全护栏(Guardrails)通过在智能体执行的关键节点对内容进行验证和过滤,帮助你构建安全、合规的 AI 应用。它们可以检测敏感信息、执行内容策略、验证输出,并在不安全行为引发问题之前予以阻止。
常见用例包括:
- 防止 PII 泄露
- 检测并拦截提示词注入攻击
- 拦截不当或有害内容
- 强制执行业务规则和合规要求
- 验证输出质量与准确性
你可以使用中间件来实现安全护栏,在战略节点拦截执行——在智能体启动之前、完成之后,或在模型和工具调用前后。
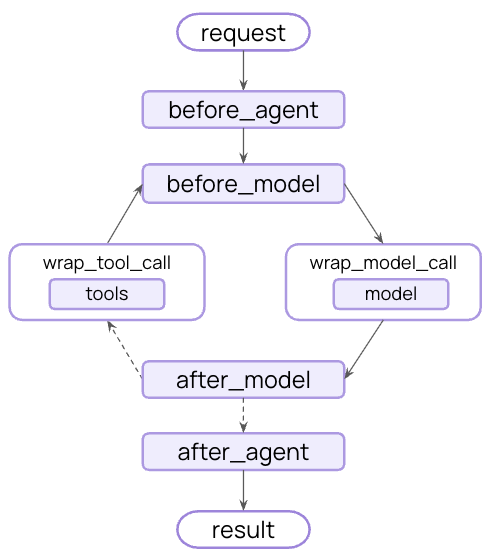
安全护栏可以通过两种互补的方法来实现:
确定性护栏(Deterministic guardrails)
使用基于规则的逻辑,例如正则表达式模式、关键词匹配或显式检查。快速、可预测且具成本效益,但可能会遗漏细微的违规行为。
基于模型的护栏(Model-based guardrails)
使用 LLM 或分类器通过语义理解来评估内容。能够捕获规则容易遗漏的微妙问题,但速度较慢且成本更高。
LangChain 既提供了内置安全护栏(例如 PII 检测、人在回路),也提供了一个灵活的中间件系统,可使用这两种方法构建自定义安全护栏。
内置安全护栏
PII 检测
LangChain 提供了内置中间件,用于检测和处理对话中的个人身份信息(PII)。该中间件可以检测常见的 PII 类型,如电子邮件、信用卡、IP 地址等。
PII 检测中间件适用于以下场景:具有合规要求的医疗和金融应用、需要脱敏日志的客服智能体,以及通常任何处理敏感用户数据的应用。
PII 中间件支持多种处理已检测到 PII 的策略:
| 策略 | 说明 | 示例 |
|---|---|---|
redact | 替换为 [REDACTED_{PII_TYPE}] | [REDACTED_EMAIL] |
mask | 部分遮蔽(例如后 4 位数字) | ****-****-****-1234 |
hash | 替换为确定性哈希值 | a8f5f167... |
block | 检测到时抛出异常 | 抛出错误 |
import { createAgent, piiMiddleware } from "langchain";

const agent = createAgent({
  model: "gpt-5.5",
  tools: [customerServiceTool, emailTool],
  middleware: [
    // 在发送给模型之前,对用户输入中的电子邮件进行脱敏
    piiMiddleware("email", {
      strategy: "redact",
      applyToInput: true,
    }),
    // 遮蔽用户输入中的信用卡号
    piiMiddleware("credit_card", {
      strategy: "mask",
      applyToInput: true,
    }),
    // 拦截 API 密钥——检测到时抛出错误
    piiMiddleware("api_key", {
      detector: /sk-[a-zA-Z0-9]{32}/,
      strategy: "block",
      applyToInput: true,
    }),
  ],
});

// 当用户提供 PII 时,将根据策略进行处理
const result = await agent.invoke({
  messages: [{
    role: "user",
    content: "My email is john.doe@example.com and card is 5105-1051-0510-5100"
  }]
});
内置 PII 类型与配置
内置 PII 类型:
credit_card- 信用卡号(经过 Luhn 算法验证)ip- IP 地址mac_address- MAC 地址url- URL 地址配置选项:
参数 说明 默认值 piiType要检测的 PII 类型(内置或自定义) 必填 strategy如何处理检测到的 PII( "block"、"redact"、"mask"、"hash")"redact"detector自定义检测器正则表达式模式 undefined(使用内置检测器)applyToInput在模型调用前检查用户消息 trueapplyToOutput在模型调用后检查 AI 消息 falseapplyToToolResults在执行后检查工具结果消息 false
有关 PII 检测功能的完整详情,请参阅中间件文档。
人在回路
LangChain 提供了内置中间件,用于在执行敏感操作之前要求人工批准。这是应对高风险决策最有效的安全护栏之一。
人在回路(Human-in-the-loop)中间件适用于以下场景:金融交易与转账、删除或修改生产数据、向外部人员发送通信,以及任何具有重大业务影响的操作。
import { createAgent, humanInTheLoopMiddleware } from "langchain";
import { MemorySaver, Command } from "@langchain/langgraph";

const agent = createAgent({
  model: "gpt-5.5",
  tools: [searchTool, sendEmailTool, deleteDatabaseTool],
  middleware: [
    humanInTheLoopMiddleware({
      interruptOn: {
        // 对敏感操作要求审批
        send_email: { allowAccept: true, allowEdit: true, allowRespond: true },
        delete_database: { allowAccept: true, allowEdit: true, allowRespond: true },
        // 自动批准安全操作
        search: false,
      }
    }),
  ],
  checkpointer: new MemorySaver(),
});

// 人在回路需要 thread ID 来实现状态持久化
const config = { configurable: { thread_id: "some_id" } };

// 智能体在执行敏感工具之前会暂停并等待审批
let result = await agent.invoke(
  { messages: [{ role: "user", content: "Send an email to the team" }] },
  config
);

result = await agent.invoke(
  new Command({ resume: { decisions: [{ type: "approve" }] } }),
  config  // 使用相同的 thread ID 来恢复暂停的对话
);
TIP
有关实现审批工作流的完整详情,请参阅人在回路文档。
自定义安全护栏
对于更复杂的安全护栏,你可以创建在智能体执行之前或之后运行的自定义中间件。这使你能够完全掌控验证逻辑、内容过滤和安全检查。
智能体执行前护栏
使用“before agent(智能体执行前)”钩子在每次调用开始时对请求进行一次验证。这适用于会话级检查,例如身份验证、速率限制,或在开始任何处理之前拦截不当请求。
import { createMiddleware, AIMessage } from "langchain";

const contentFilterMiddleware = (bannedKeywords: string[]) => {
  const keywords = bannedKeywords.map(kw => kw.toLowerCase());

  return createMiddleware({
    name: "ContentFilterMiddleware",
    beforeAgent: {
      hook: (state) => {
        // 获取第一条用户消息
        if (!state.messages || state.messages.length === 0) {
          return;
        }

        const firstMessage = state.messages[0];
        if (firstMessage._getType() !== "human") {
          return;
        }

        const content = firstMessage.content.toString().toLowerCase();

        // 检查违禁关键词
        for (const keyword of keywords) {
          if (content.includes(keyword)) {
            // 在进行任何处理之前阻止执行
            return {
              messages: [
                new AIMessage(
                  "I cannot process requests containing inappropriate content. Please rephrase your request."
                )
              ],
              jumpTo: "end",
            };
          }
        }

        return;
      },
      canJumpTo: ['end']
    }
  });
};

// 使用自定义安全护栏
import { createAgent } from "langchain";

const agent = createAgent({
  model: "gpt-5.5",
  tools: [searchTool, calculatorTool],
  middleware: [
    contentFilterMiddleware(["hack", "exploit", "malware"]),
  ],
});

// 该请求将在进行任何处理之前被拦截
const result = await agent.invoke({
  messages: [{ role: "user", content: "How do I hack into a database?" }]
});
智能体执行后护栏
使用“after agent(智能体执行后)”钩子在将最终输出返回给用户之前对其进行一次验证。这适用于基于模型的安全检查、质量验证,或对完整的智能体响应进行最终合规性扫描。
import { createMiddleware, AIMessage, initChatModel } from "langchain";

const safetyGuardrailMiddleware = () => {
  const safetyModel = initChatModel("gpt-5.4-mini");

  return createMiddleware({
    name: "SafetyGuardrailMiddleware",
    afterAgent: {
      hook: async (state) => {
        // 获取最终的 AI 响应
        if (!state.messages || state.messages.length === 0) {
          return;
        }

        const lastMessage = state.messages[state.messages.length - 1];
        if (lastMessage._getType() !== "ai") {
          return;
        }

        // 使用模型评估安全性
        const safetyPrompt = `Evaluate if this response is safe and appropriate.
        Respond with only 'SAFE' or 'UNSAFE'.

        Response: ${lastMessage.content.toString()}`;

        const result = await safetyModel.invoke([
          { role: "user", content: safetyPrompt }
        ]);

        if (result.content.toString().includes("UNSAFE")) {
          return {
            messages: [
              new AIMessage(
                "I cannot provide that response. Please rephrase your request."
              )
            ],
            jumpTo: "end",
          };
        }

        return;
      },
      canJumpTo: ['end']
    }
  });
};

// 使用安全护栏
import { createAgent } from "langchain";

const agent = createAgent({
  model: "gpt-5.5",
  tools: [searchTool, calculatorTool],
  middleware: [safetyGuardrailMiddleware()],
});

const result = await agent.invoke({
  messages: [{ role: "user", content: "How do I make explosives?" }]
});
组合多种安全护栏
你可以通过将多个安全护栏添加到中间件数组中来进行堆叠。它们按顺序执行,使你能够构建分层防护体系:
import { createAgent, piiMiddleware, humanInTheLoopMiddleware } from "langchain";

const agent = createAgent({
  model: "gpt-5.5",
  tools: [searchTool, sendEmailTool],
  middleware: [
    // 第 1 层:确定性输入过滤器(智能体执行前)
    contentFilterMiddleware(["hack", "exploit"]),

    // 第 2 层:PII 保护(模型调用前后)
    piiMiddleware("email", {
      strategy: "redact",
      applyToInput: true,
    }),
    piiMiddleware("email", {
      strategy: "redact",
      applyToOutput: true,
    }),

    // 第 3 层:针对敏感工具的人工审批
    humanInTheLoopMiddleware({
      interruptOn: {
        send_email: { allowAccept: true, allowEdit: true, allowRespond: true },
      }
    }),

    // 第 4 层:基于模型的安全检查(智能体执行后)
    safetyGuardrailMiddleware(),
  ],
});
更多资源
- 中间件文档 - 自定义中间件完整指南
- 中间件 API 参考 - 自定义中间件完整指南
- 人在回路 - 为敏感操作添加人工审查
- 测试智能体 - 测试安全机制的策略